意外的發現(Chroneme)
 Zohaib Akhtar
譯自英文。 閱讀原文
這週有些意外的發現。多數臨床 AI 模型,走不到第二家醫院就卡住了。Epic 的敗血症模型就是教科書等級的例子。它是美國部署最廣的臨床 AI 工具之一,在數百家醫院上線運作。它的賣點是能在病人發生敗血症的幾小時前,就先提醒醫師。
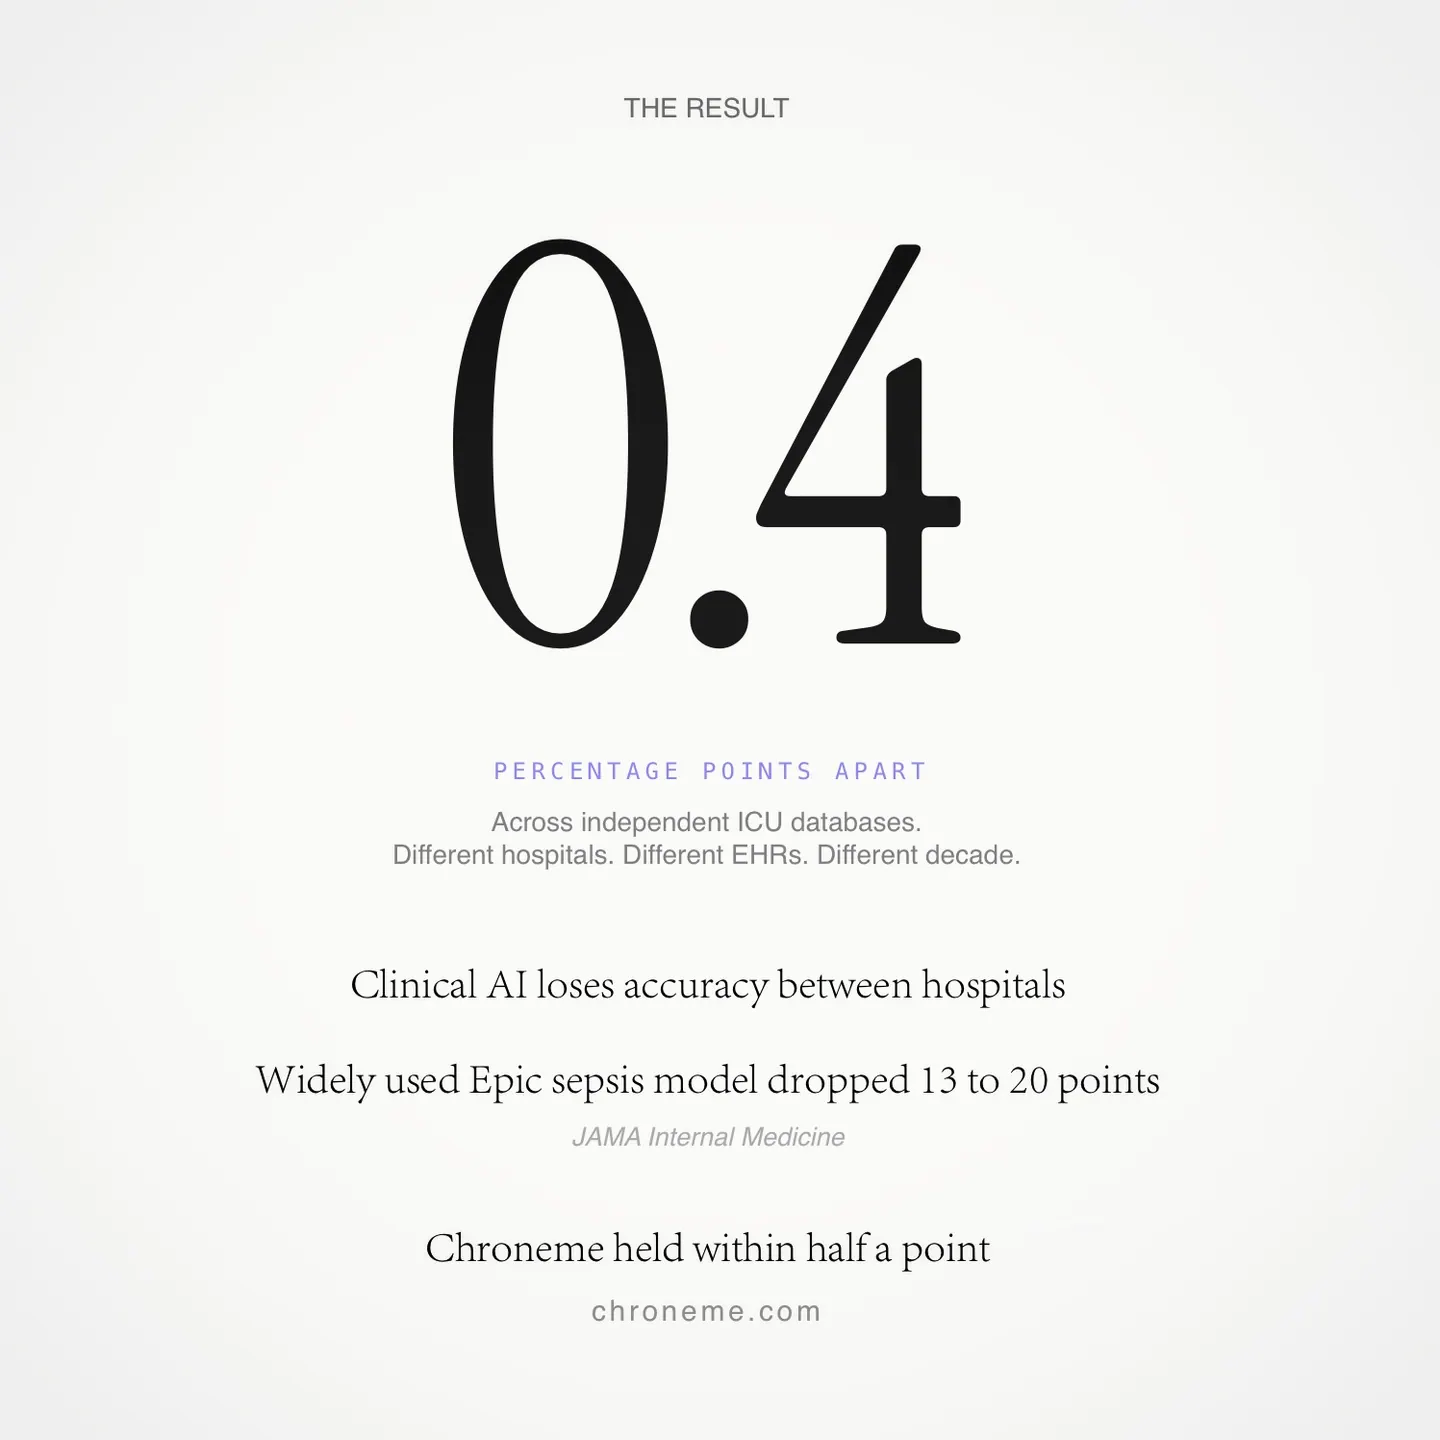
2021年,密西根的一個團隊獨立測試了這個模型,結果發表在 JAMA Internal Medicine。模型只抓到三分之一的敗血症病例,對大約五分之一的住院病人發出警示,準確度也比 Epic 自己公布的數字低了13到20個點。
這並不罕見。這個現象有個名字,叫跨資料庫崩潰。模型學到的是某一家醫院怎麼記錄資料,一碰到另一家,優勢就沒了。
我打造 Chroneme,是從另一個前提出發。如果一套系統讀的是身體實際上如何隨時間變化,而不是醫院怎麼記錄,它就應該能在不同醫院之間通用。而且不該只限於一種疾病。Epic 預測的是敗血症。Chroneme 讀的是軌跡,所以同一套引擎能標記出任何嚴重到需要升壓劑、插管或透析的惡化。
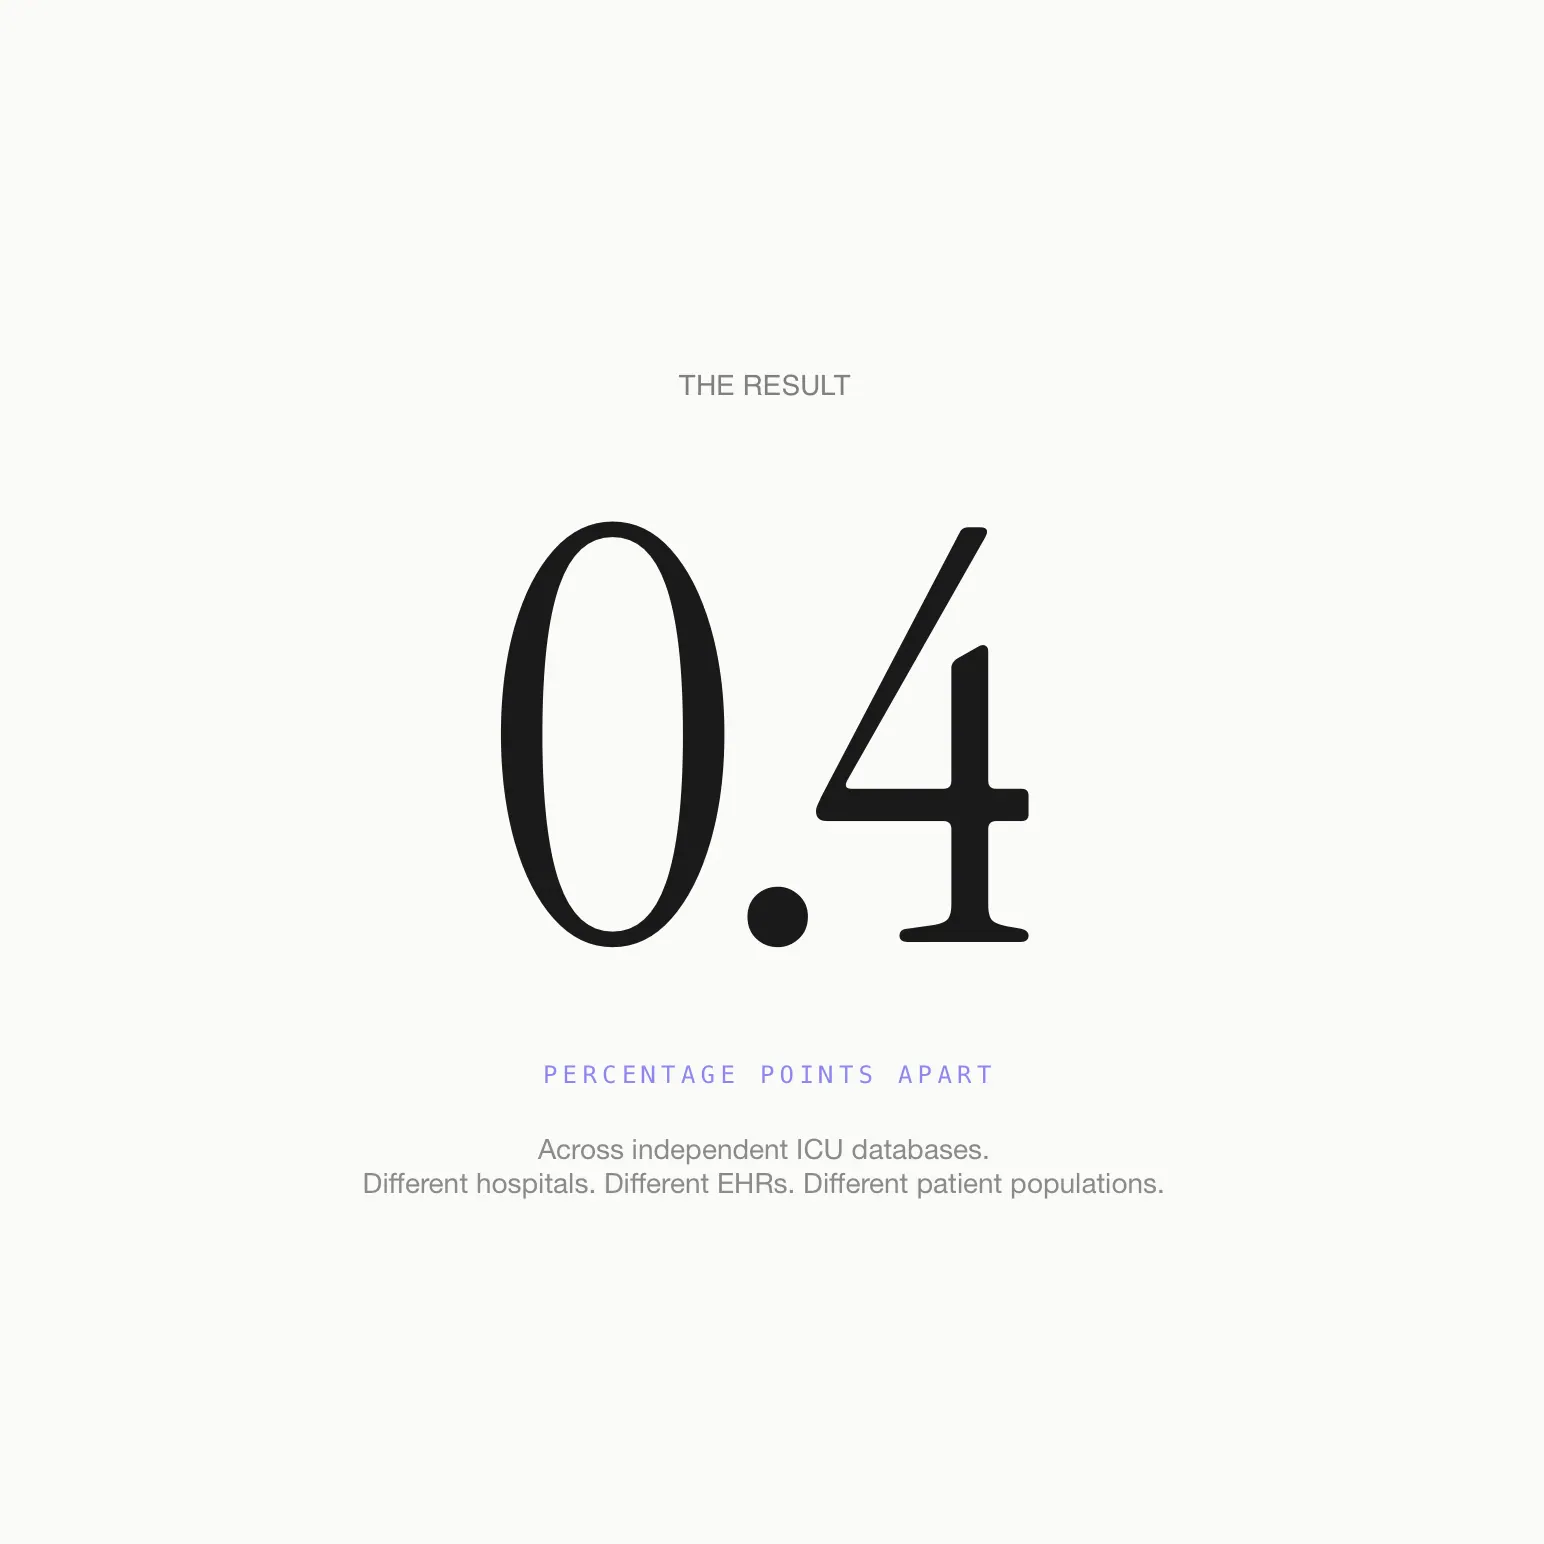
我在兩個龐大、完全獨立的加護病房資料庫上做了測試。不同的醫院、不同的電子病歷系統、不同的年代。兩邊的結果相差不到半個點。在臨床 AI 裡,跨資料庫能一致到這種程度相當少見,更何況這是一個在任何介入之前就量測的複合結果。這種崩潰不是自然法則,而是多數模型建構方式本身的特性。Chroneme 的結果暗示,還有另一條路。
半個點的差距之所以重要,在於它從等式裡拿掉了什麼。大多數臨床 AI 每到一家新醫院,都得重新驗證、重新調校,有時甚至要重新訓練。好模型會卡住,原因就在這筆成本。如果一套系統能在不同醫院、不同電子病歷、不同年代之間維持準確度,部署這件事的樣貌就會跟著改變。主管機關只需要評估一次。醫療體系可以直接在它上面發展,不必從頭重建。臨床 AI 的天花板一直是泛化能力。Chroneme 的結果暗示,這片天花板是可以往上推的。
如果你在做臨床 AI,請告訴我,這套說法會在哪裡破功。
((Z))