意外发现(Chroneme)
 Zohaib Akhtar
译自英文。 阅读英文原文
这周有些意外的发现。大多数临床人工智能模型,还没走进第二家医院就停滞不前了。Epic 的脓毒症模型就是教科书式的例子。它是美国部署最广的临床人工智能工具之一,在数百家医院运行。它的卖点是:能在患者发生脓毒症的几小时前就向医生预警。
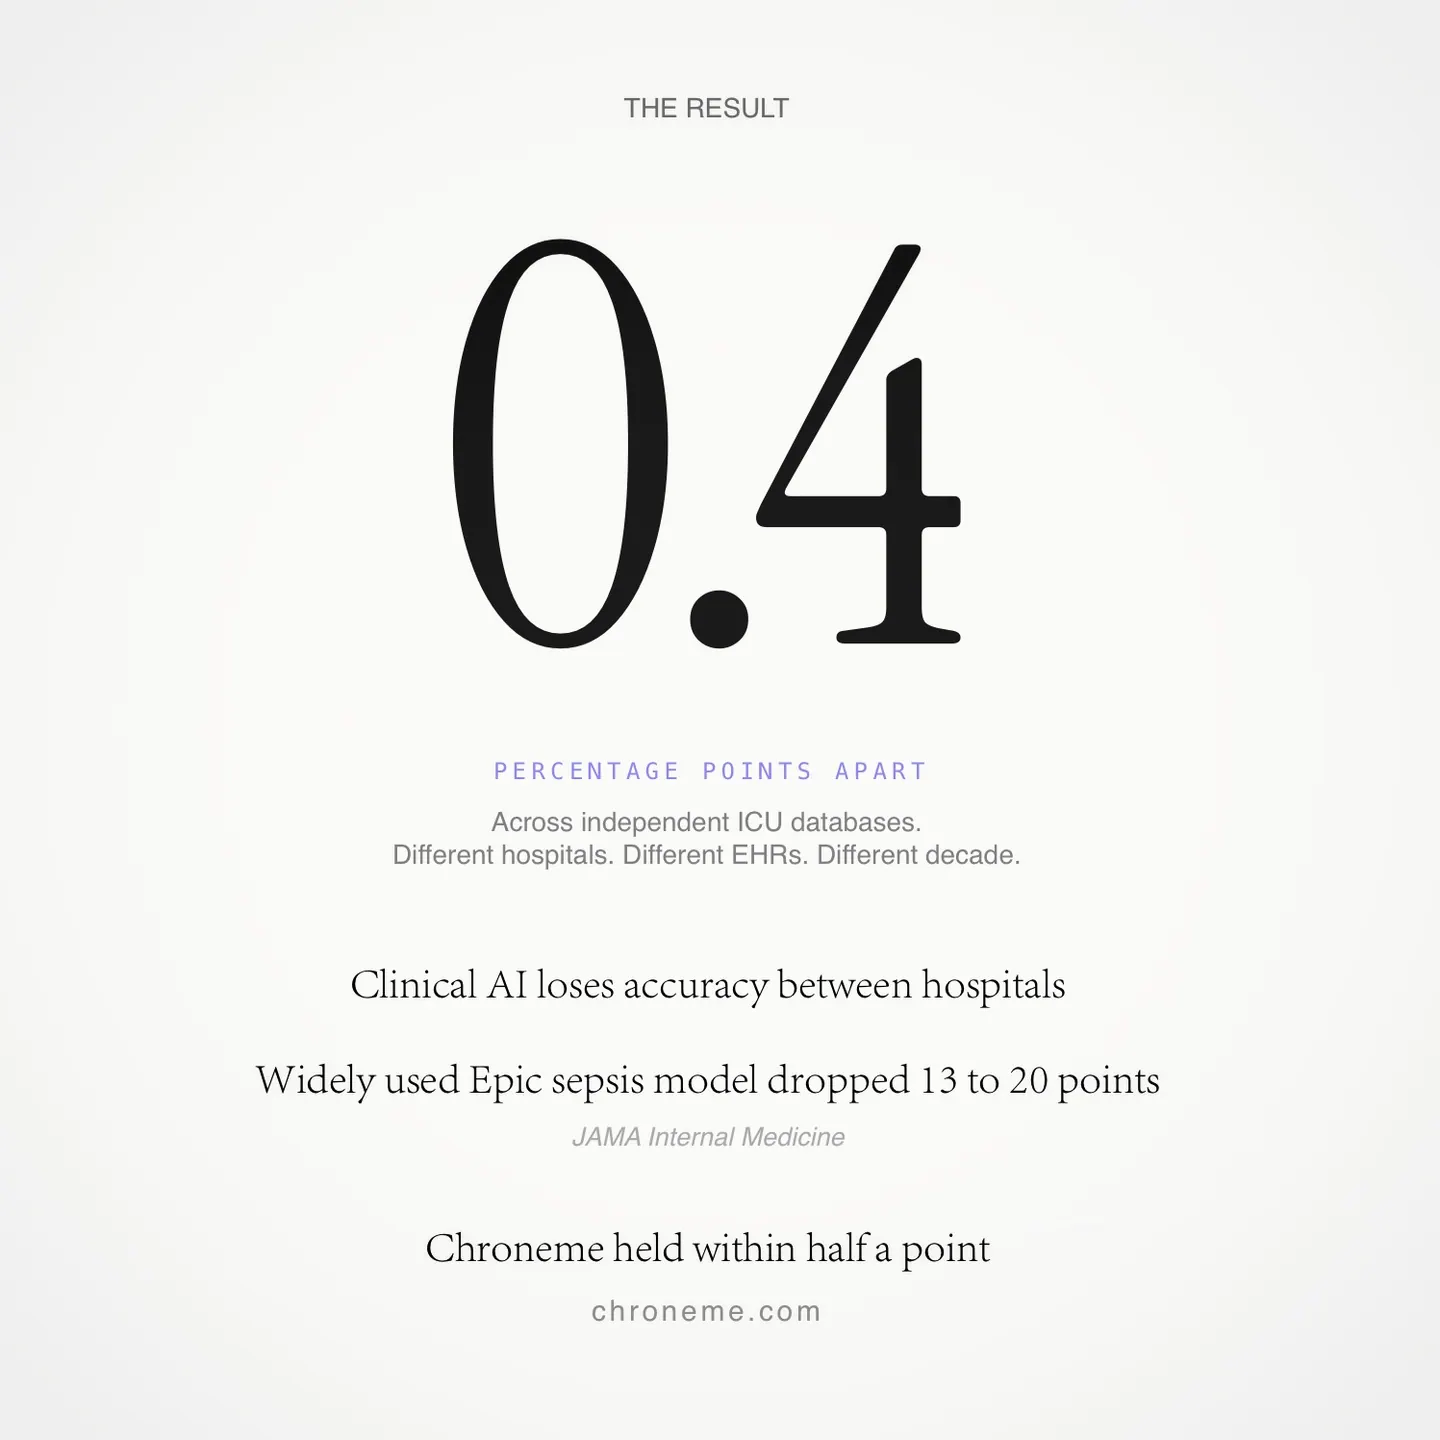
2021 年,密歇根的一个团队对它做了独立测试,结果发表在 JAMA Internal Medicine 上。该模型只发现了三分之一的脓毒症病例,却给大约五分之一的住院病例亮了警报,准确率比 Epic 自己公布的低了 13 到 20 个百分点。
这并不罕见。这种现象有个名字:跨数据库崩溃。模型学到的,是某一家机构记录数据的方式,一旦换了一家,优势便荡然无存。
我创办 Chroneme,出发点不一样。一个系统如果读的是身体随时间真实发生的变化,而不是医院怎么记录这些变化,就应该能在医院之间通用。而且它不该只盯着一种病。Epic 预测的是脓毒症。Chroneme 读的是病情轨迹,所以同一个引擎,能识别出任何严重到需要升压药、气管插管或透析的病情恶化。
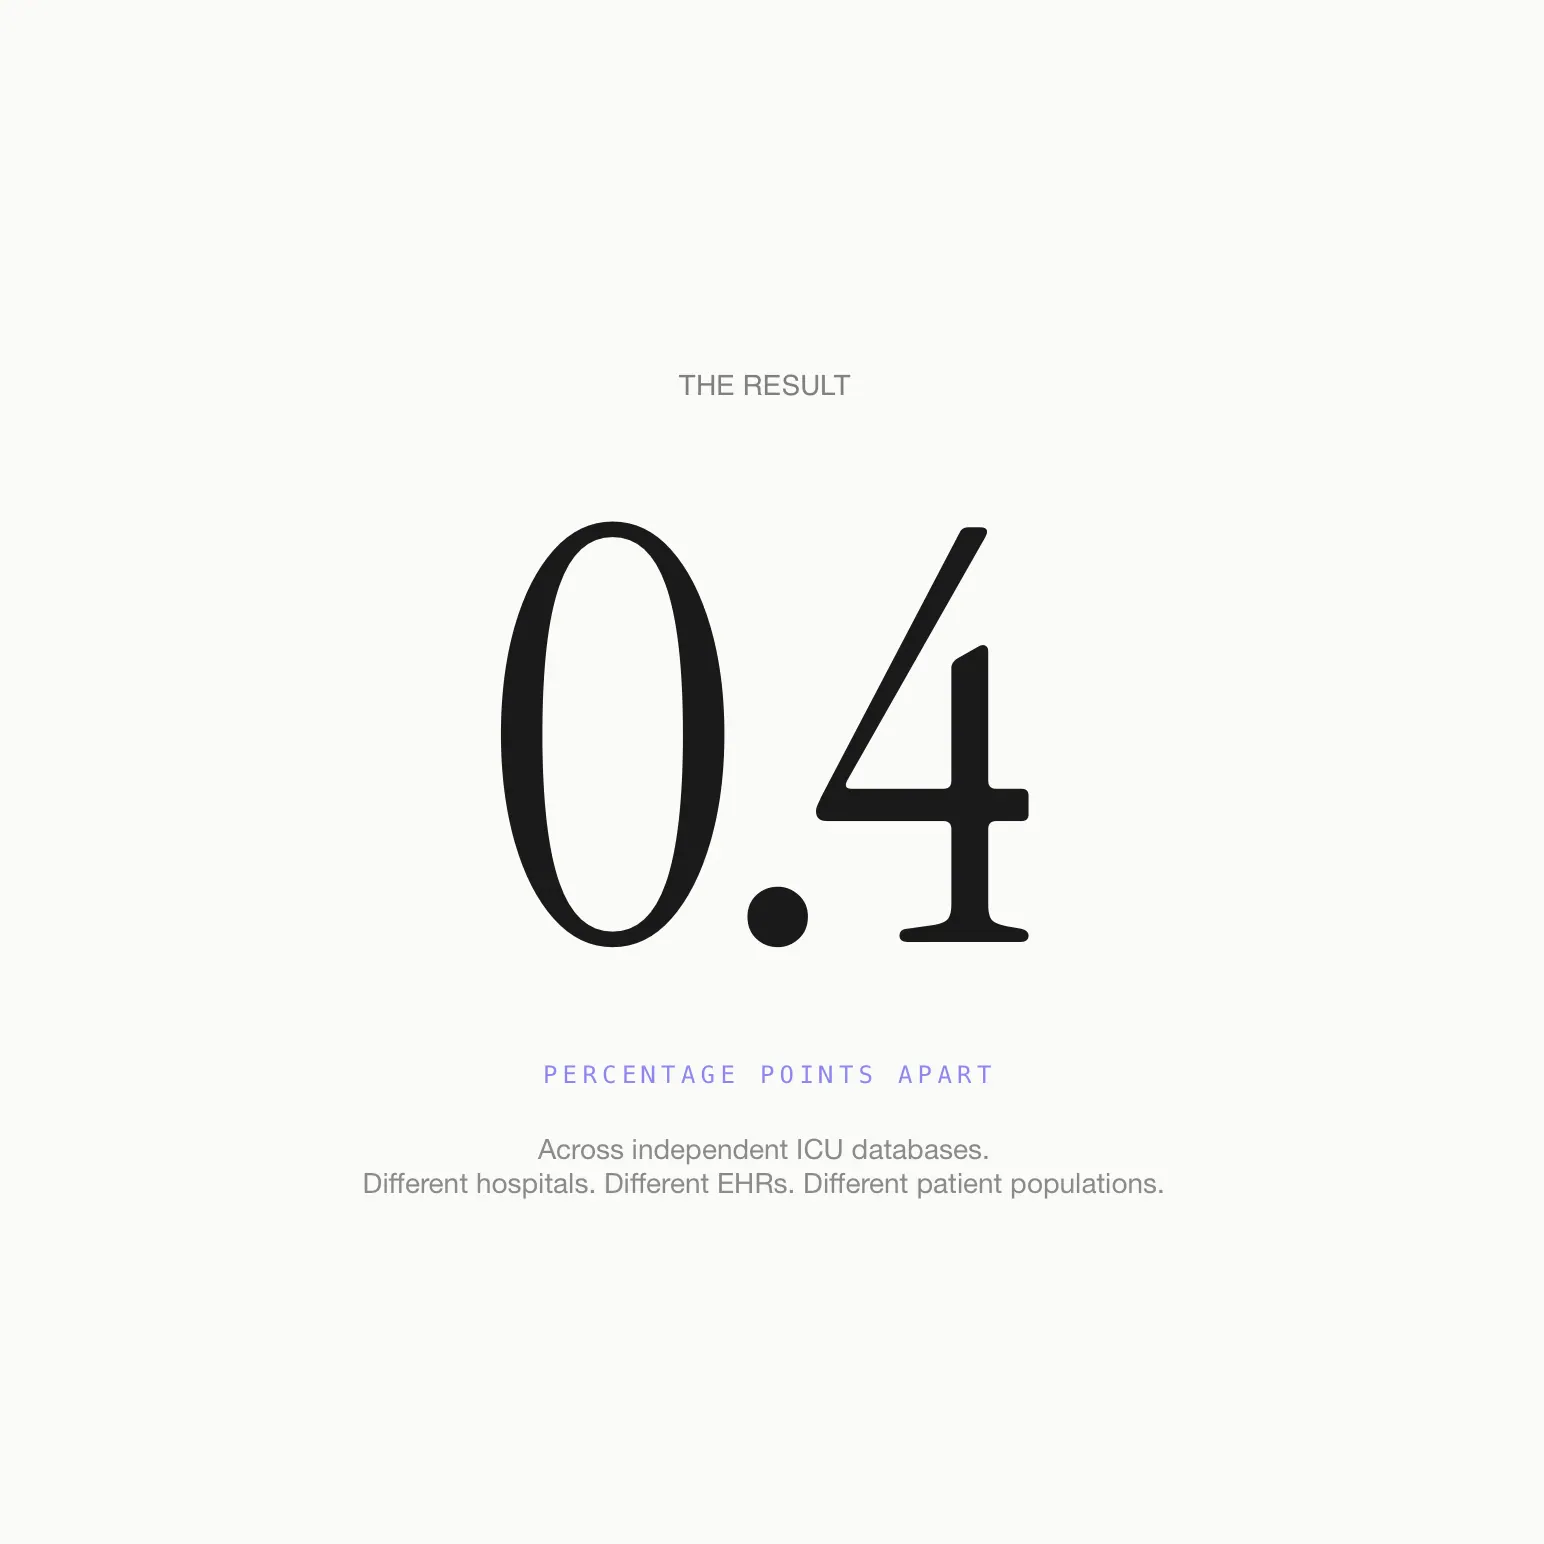
我在两个规模庞大、彼此完全独立的 ICU 数据库上做了测试。不同的医院,不同的电子病历系统,不同的年代。两边结果相差不到半个百分点。在临床人工智能里,跨数据库的一致性做到这么接近,十分少见,尤其这还是一个在任何干预之前就测量的复合结局。崩溃不是自然规律。它是大多数模型构建方式的产物。Chroneme 表明,还有另一条路。
半个百分点的差距之所以要紧,在于它从等式中拿掉了什么。大多数临床人工智能每到一个新地方,都得重新验证、重新调参,有时还得重新训练。正是这笔成本,让好模型停滞不前。如果一个系统能跨医院、跨电子病历系统、跨年代保持准确率,部署工作的形态就变了。监管机构只需评估一次。医疗系统可以直接在它之上搭建,而不用推倒重来。临床人工智能的天花板,一直是泛化能力。Chroneme 表明,这块天花板是可以抬高的。
如果你在做临床人工智能,请告诉我,这套说法在哪里站不住脚。
((Z))